自動對嘴的影片虛擬人像
您的虛擬人像能根據任何腳本或音軌同步說話、眨眼與動作,隨時準備進行簡報、旁白或表演。
線上 AI 虛擬人像影片生成器
使用 AI 虛擬人像影片生成器,從一張照片、一段提示文字或參考圖像,輕鬆打造會說話的 AI 虛擬人像。自動對嘴、生動動畫,可直接嵌入任何影片中。免費開始使用。
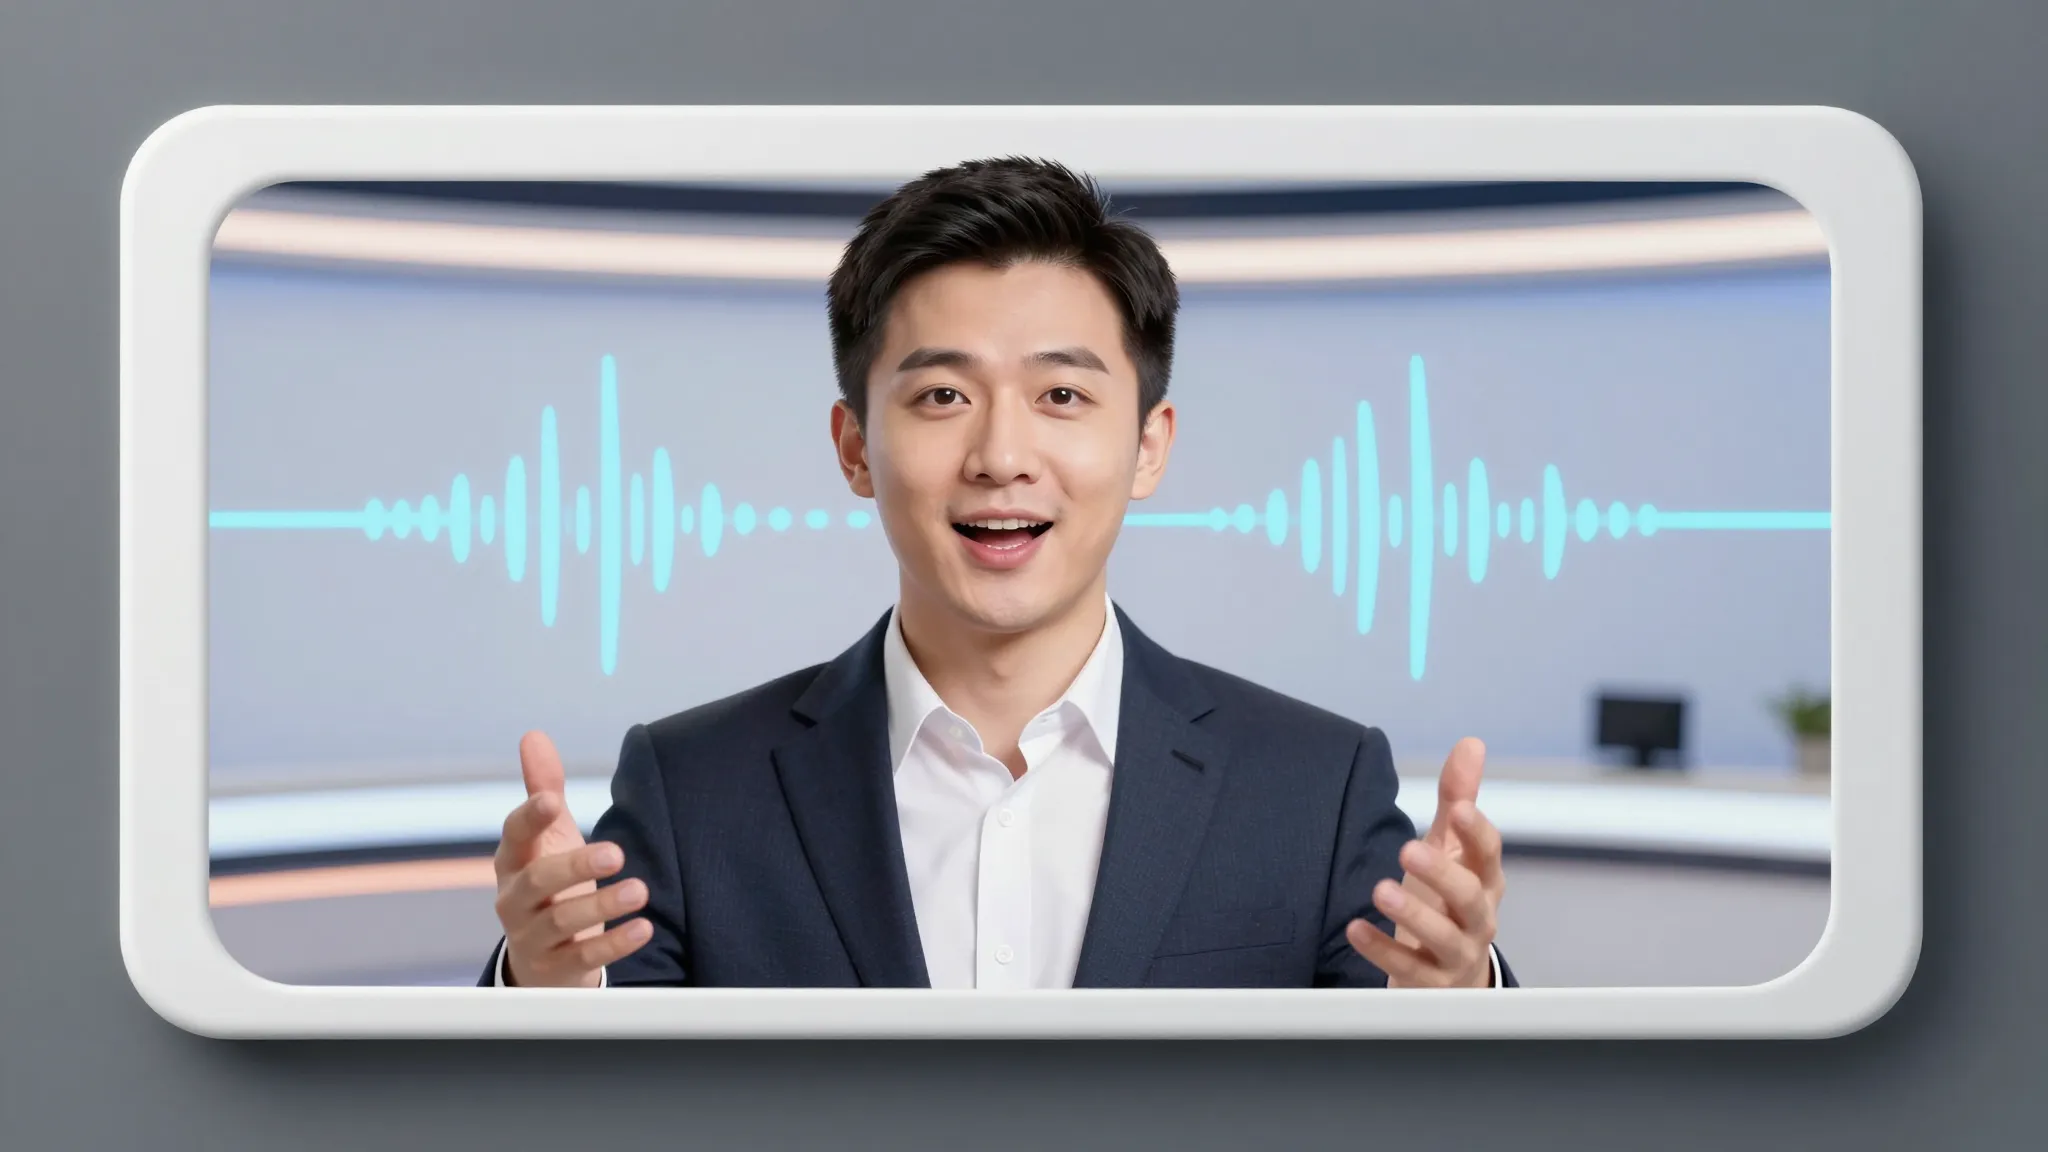
您的虛擬人像能根據任何腳本或音軌同步說話、眨眼與動作,隨時準備進行簡報、旁白或表演。
您可以使用自己的照片、文字提示或自訂參考圖像來建立虛擬人像。無論您提供什麼素材,AI 都能幫您完成後續製作。
將您的虛擬人像應用於簡報、課程、無真人出鏡影片、VTuber 直播或品牌內容中。免費試用,無需註冊帳戶。
創意無限
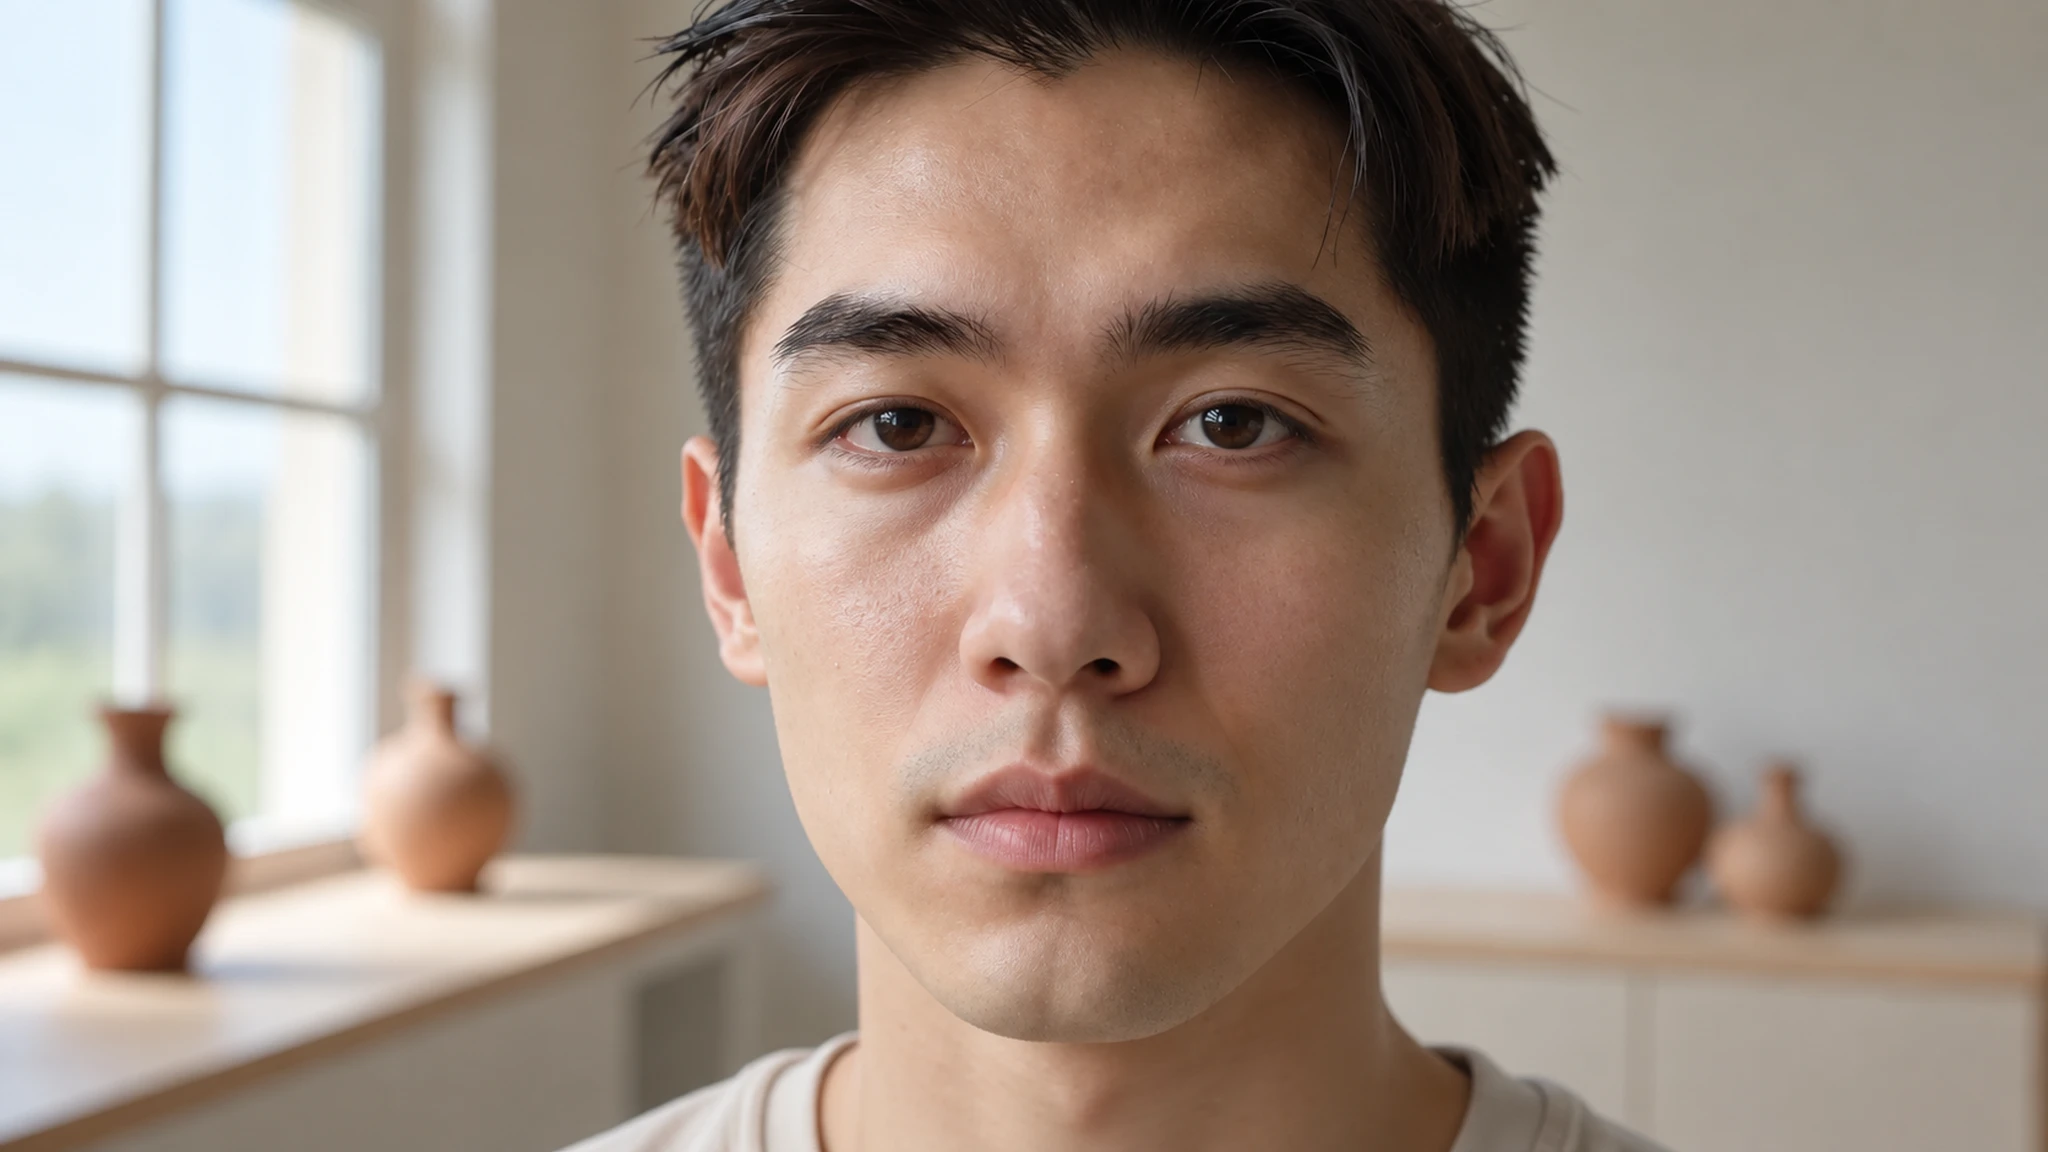
幾個視覺方向,激發您的下一個創作。這些範例展示了您可以探索的風格與點子。
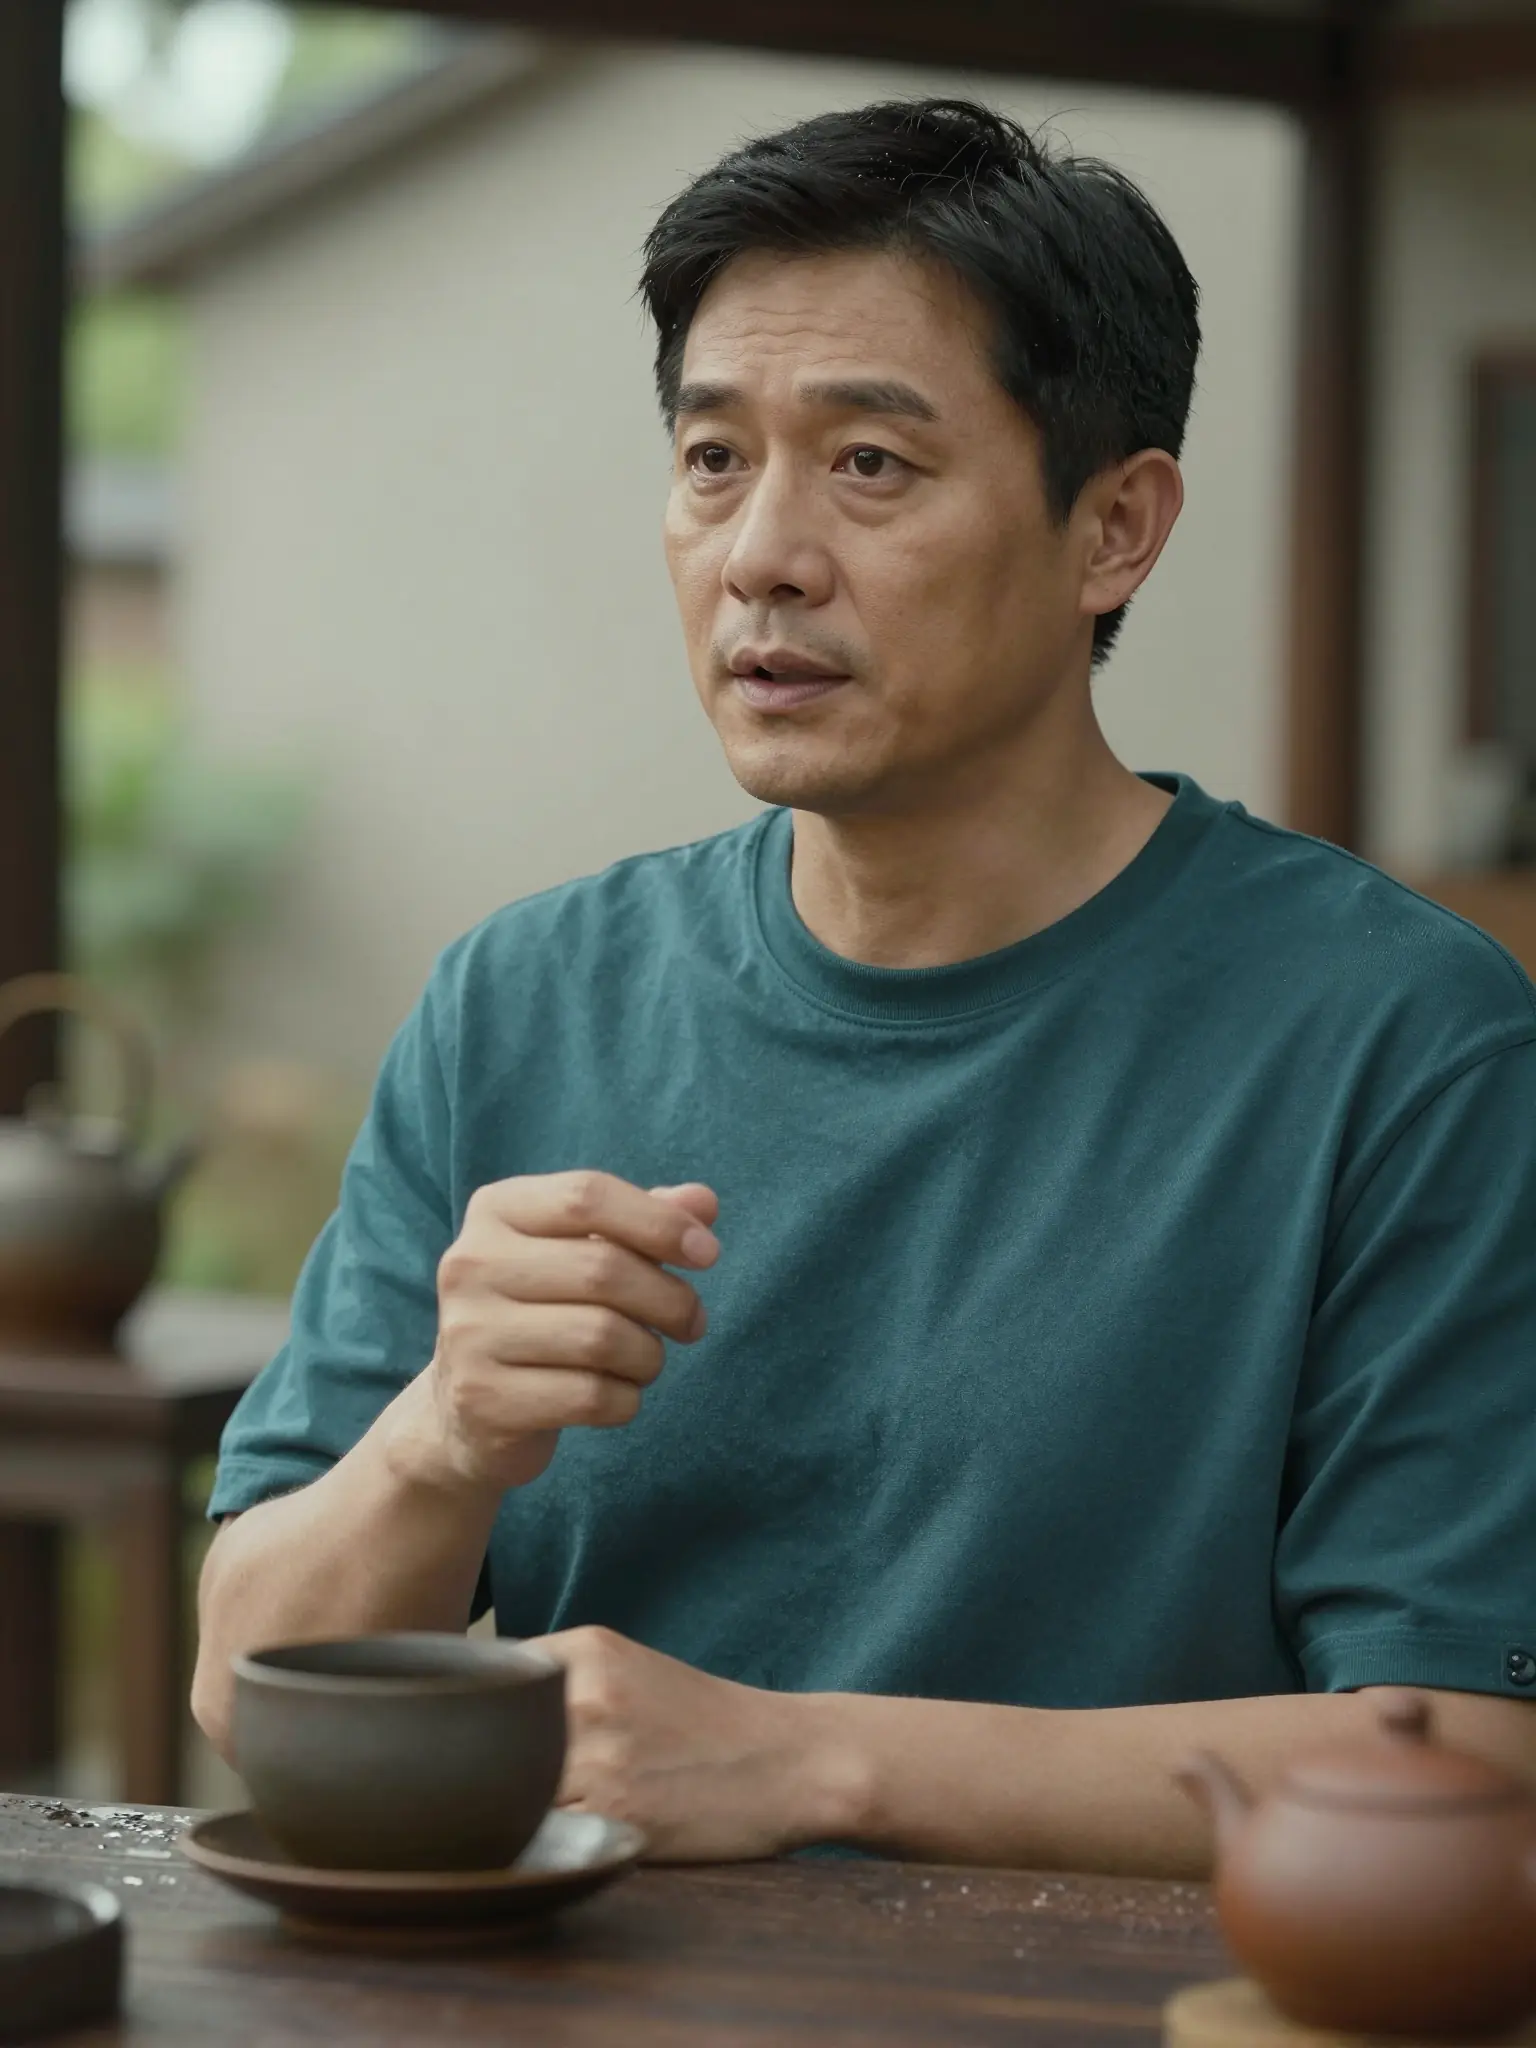
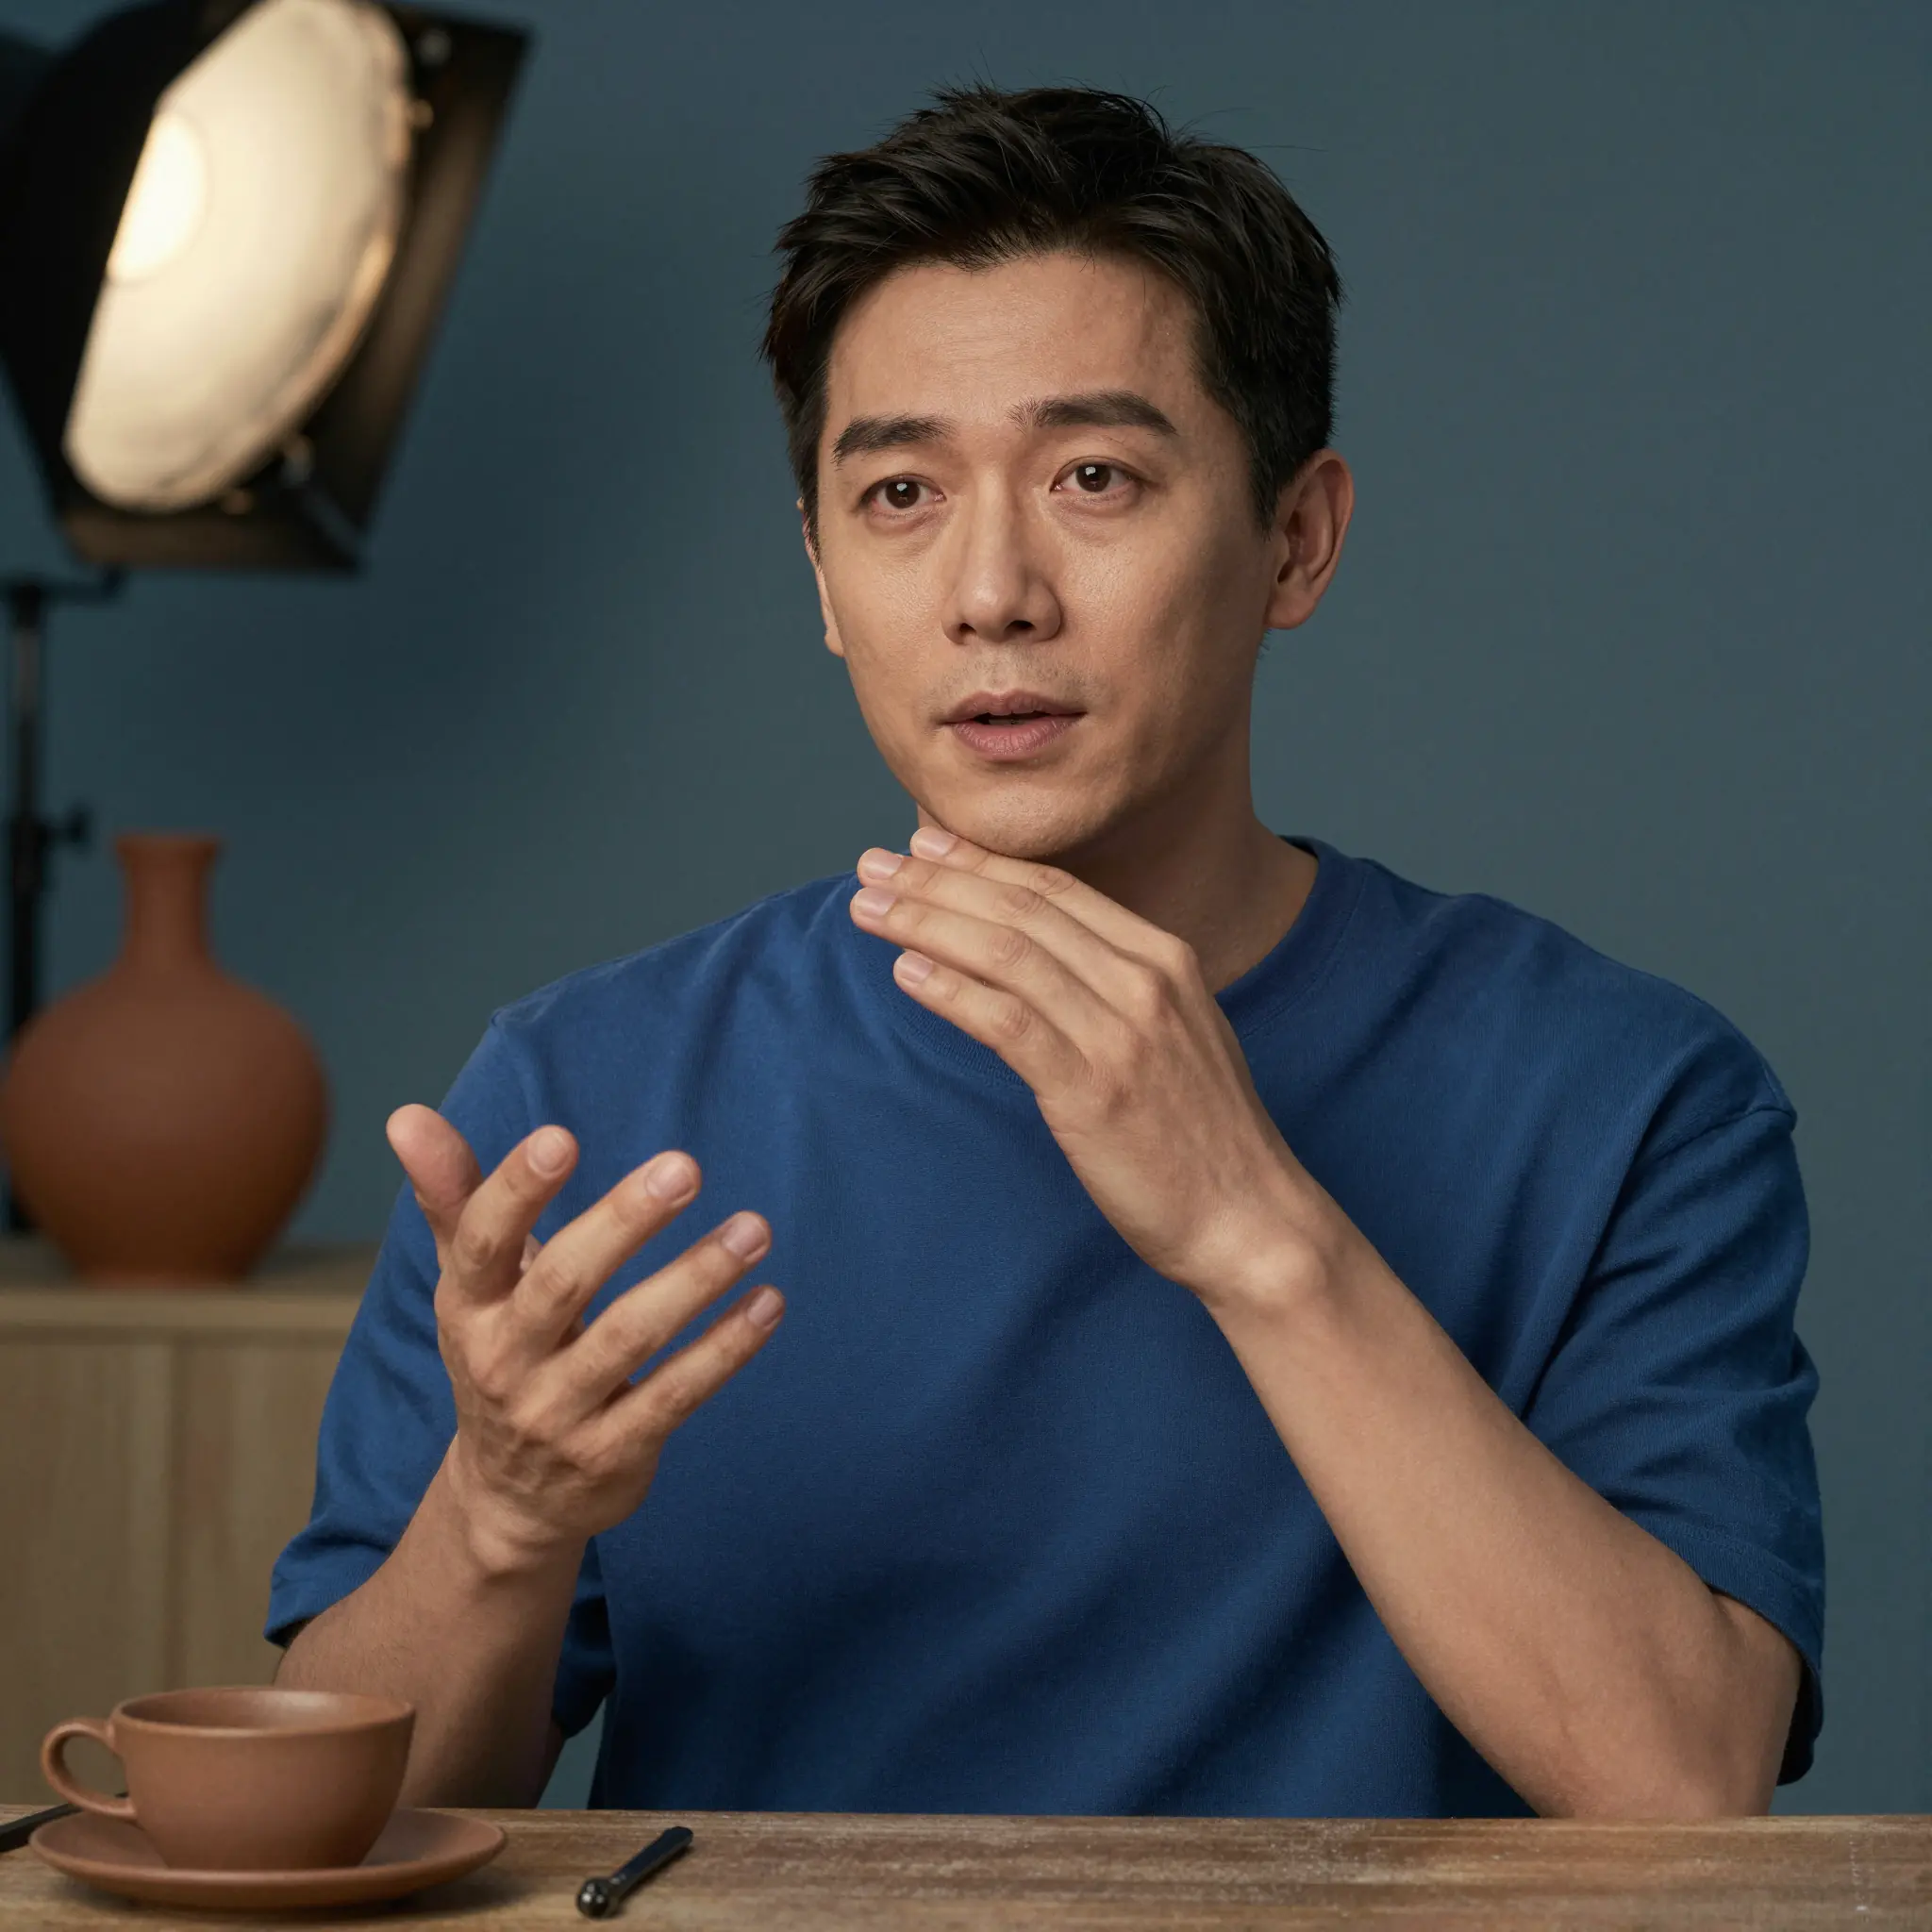
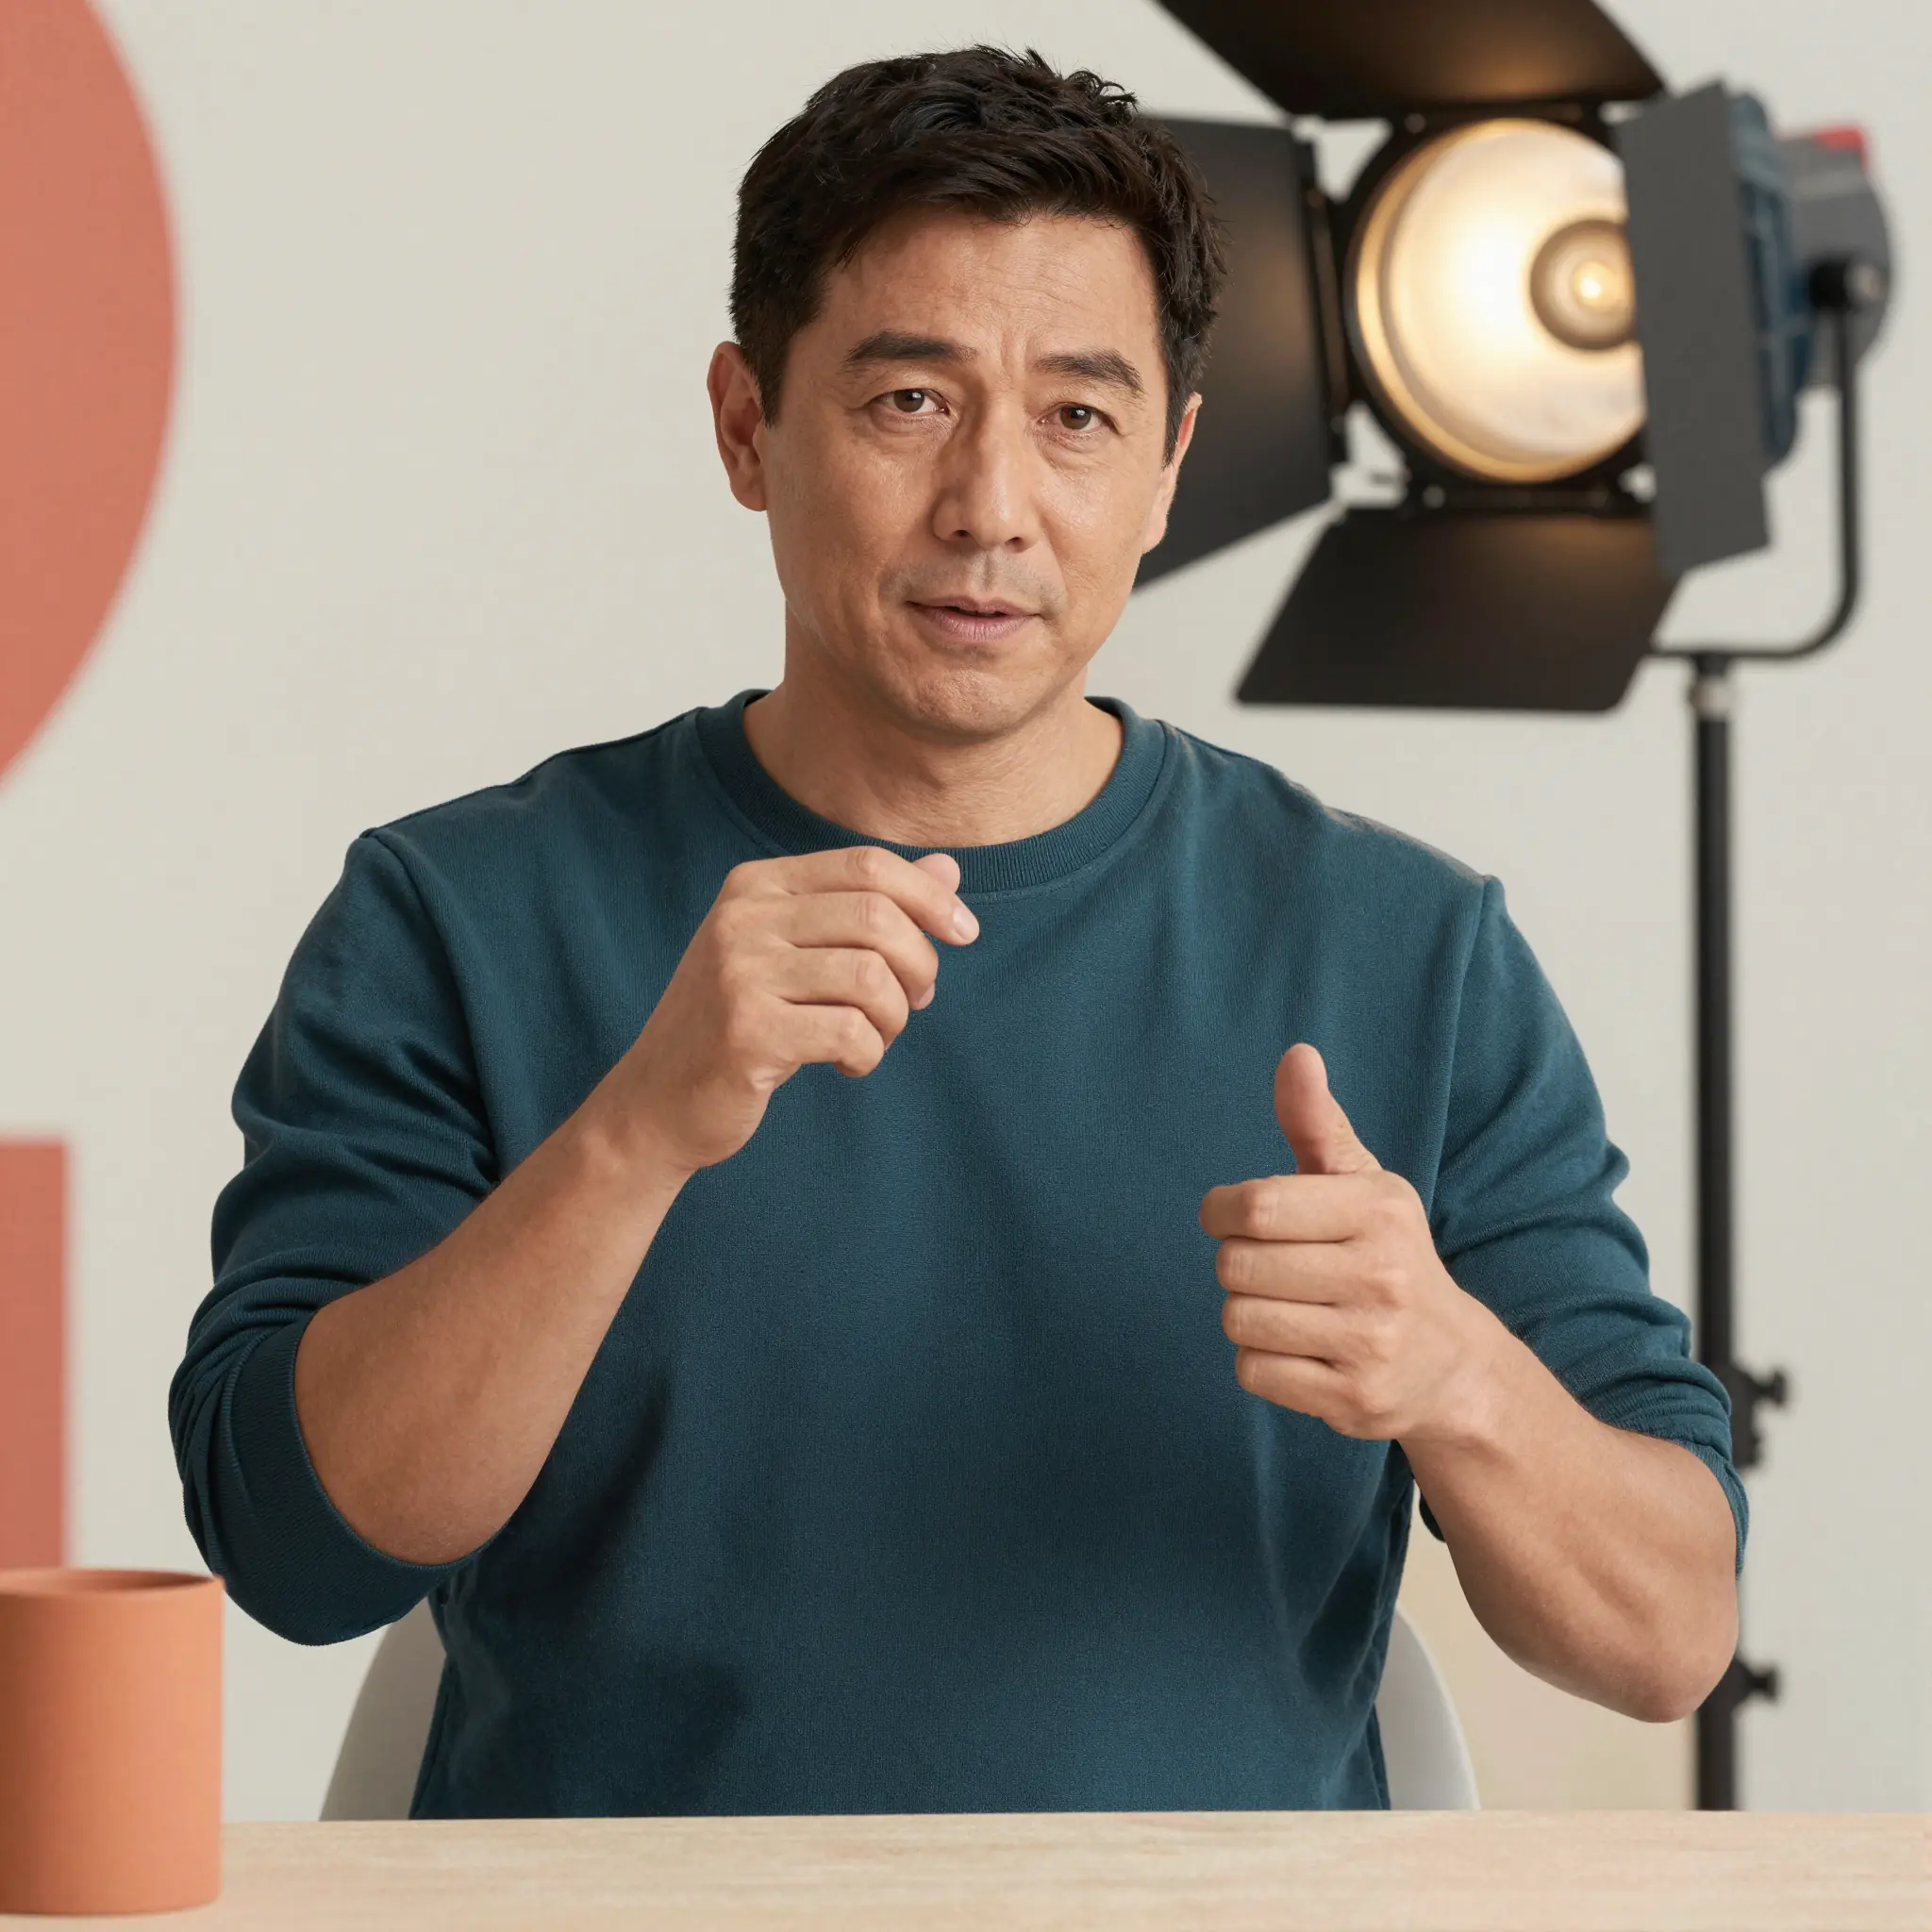
只要上傳一張清晰的人臉照片,AI 就能生成逼真的會說話虛擬人像,完整保留面部結構、表情與外貌特徵。即使在不同角度、光線與動作下,人像仍能保持一致,讓每一幀都呈現同一個人物。無需 3D 模型、掃描設備或專業攝影棚,僅需一張照片,即可獲得適合所有頻道影片使用的專業級虛擬主持人。
立即嘗試一旦建立好虛擬人像,AI 即可根據您提供的腳本或音訊為其添加動畫效果:嘴型與語音同步、眼睛自然眨動與轉移視線,並搭配細微的頭部動作,使整體表現更生動自然,而非僵硬呆板。無論是錄製好的旁白、AI 生成語音,還是純文字腳本,虛擬人像都能以真實可信的節奏說出內容,產出真正可發布的「會說話頭像」,而非只是對著鏡頭揮手的靜態吉祥物。
立即嘗試您的虛擬人像不受限於特定模板或背景。可將其置入簡報、課程模組、YouTube 開場、產品導覽、社群短片或無真人出鏡的說明影片中。搭配 Cuta 的其他影像與影片工具,還能更換背景、調整場景風格,或將人像延伸至更長的影片序列。一個虛擬人像,滿足您頻道所需的所有格式。
立即嘗試若您希望以角色而非本人進行直播或發佈內容,AI 虛擬人像生成器可根據文字提示或參考圖像,為您打造完整的 VTuber 角色。無論您偏好動漫風、3D、插畫風或寫實風格,AI 都能生成外觀一致、表情豐富且具備精準對嘴能力的固定角色。在直播、短片與上傳內容中持續使用同一角色,讓觀眾一眼就能認出您的虛擬形象。
立即嘗試從構想到創作
上傳照片、輸入描述文字,或提供參考圖像。AI 將生成符合您期望外貌或風格的虛擬人像,並準備好進行動畫製作。
輸入腳本、貼上旁白文字,或上傳音訊檔案。AI 會讓您的虛擬人像根據音訊自動對嘴,並同步匹配表情與頭部動作。
生成會說話的虛擬人像影片,預覽效果,若需要不同版本可重新生成,最後下載為 MP4 格式,適用於您發布內容的所有平台。
以 AI 虛擬人像作為主持人,經營完整的 YouTube 頻道。只需錄製一次,即可生成數百支短片;或完全跳過拍攝環節,讓虛擬人像以一致的聲音與形象呈現每段腳本。非常適合希望擁有辨識度高之螢幕形象卻不願親自出鏡的創作者,也適合已具規模的創作者在不耗盡拍攝精力的情況下擴大內容產量。
立即嘗試透過 AI 虛擬人像講述整套課程模組,無需為每堂課親自拍攝影片。只需更新腳本並重新生成影片,虛擬人像便能以相同外觀與語調呈現新版本。特別適合線上教育者、企業培訓團隊,以及販售同期課程或常青課程的創作者——再也不必因重拍課程而拖慢每次內容迭代的進度。
立即嘗試快速製作具品牌一致性的影片內容,由 AI 虛擬人像擔任產品導覽、內部公告、銷售支援短片與行銷活動的主持人。單一人像即可主持每週公司更新、旁白說明影片,並在各平台代言新品發布,讓您的影片產出不再受限於誰有空拍攝。
立即嘗試透過單一提示或參考圖像,打造能直播、互動與發布內容的 VTuber 角色。無論是直播、YouTube 上傳或短片,皆可使用同一個固定角色,讓觀眾與角色建立情感連結,而非僅視為臨時替身。
立即嘗試以 AI 虛擬人像作為 YouTube、TikTok 或 Reels 的螢幕形象,取代傳統的素材片段加旁白模式。虛擬人像為內容增添「面孔」,卻無需暴露真實容貌,有助提升信任感、觀看時長與頻道辨識度,特別適用於財經、健康、效率提升與自我成長等領域。
立即嘗試AI 虛擬人像生成器是 Cuta 提供的一款工具,可根據照片、提示文字或參考圖像生成會說話的影片虛擬人像。該人像能根據您提供的腳本或音訊自動對嘴,並同步匹配表情與頭部動作,讓您無需親自拍攝即可獲得專業級的主持人角色。
您的下一個創作由此開始
使用 AI 虛擬人像影片生成器,讓您的想法動起來。從您自己的內容開始,在 Studio 中塑造出成果。